Pourquoi un assistant IA hébergé loin de La Réunion répond avec un délai
Oui, un délai de réponse existe pour un assistant IA utilisé depuis La Réunion quand l’outil est hébergé en métropole, en Europe continentale ou aux États-Unis. Ce délai vient du trajet réseau, pas d’un défaut de l’outil : la distance, le nombre de câbles sous-marins traversés et le nombre d’intermédiaires réseau s’additionnent avant même que le modèle commence à répondre.
La Réunion n’est pas un cas comme un autre : selon le fournisseur d’accès local ZEOP (base de connaissances, consultée le 20 septembre 2026), la distance vers un serveur situé en Europe dépasse 10 000 km, ce qui place un plancher théorique autour de 180 ms de latence, avant tout traitement côté serveur. ZEOP publie des ordres de grandeur théoriques par zone : environ 45 ms vers l’Afrique du Sud, 115 ms vers l’Asie, 200 ms vers l’Europe continentale.
Ce trajet ne passe pas par des satellites mais par des câbles sous-marins. Trois liaisons desservent aujourd’hui l’île : SAFE (2002, moins de 1 Tbit/s, en fin de vie, démantèlement prévu à partir de 2027), LION et LION 2 (depuis 2009, 1,2 Tbit/s, vers Madagascar puis Mayotte et le Kenya) et METISS (depuis 2018, 24 Tbit/s), qui transporte aujourd’hui l’essentiel du trafic entrant et sortant de l’île. Un nouveau câble, ReuNION, a été annoncé le 2 septembre 2026 : il reliera la côte ouest de l’île à Durban (Afrique du Sud) avec 16 paires de fibre d’environ 20 Tbit/s chacune, pour un investissement de 93,1 millions d’euros, dont plus de 50 millions de fonds européens (Feder et Connecting Europe Facility).
- Poste à La RéunionRéseau local, box ou connexion filaire.
- Câble sous-marinSAFE, LION/LION 2 ou METISS selon la route.
- Serveur du modèleEurope, États-Unis ou point de présence plus proche.
- Modèle hébergé en Europe ou aux États-UnisPlancher théorique autour de 180 à 200 ms, avant traitement.
- Traitement proche via un point de présence localUne partie du trajet s’arrête plus tôt ; le calcul du modèle reste ailleurs.
| Câble | En service depuis | Capacité | Rôle |
|---|---|---|---|
| SAFE | 2002 | Moins de 1 Tbit/s | Historique ; fin de vie annoncée à partir de 2027. |
| LION / LION 2 | 2009 | 1,2 Tbit/s | Vers Madagascar, puis Mayotte et le Kenya. |
| METISS | 2018 | 24 Tbit/s | Transport principal du trafic actuel. |
| ReuNION (annoncé) | Annoncé le 02/09/2026 | ≈ 20 Tbit/s par paire, 16 paires | Réunion vers Durban (Afrique du Sud), 93,1 M€ d’investissement. |
Faites défiler le tableau pour comparer les colonnes
Ce que ce délai change concrètement pour un usage professionnel
Un délai de quelques centaines de millisecondes ne se vit pas de la même façon selon l’usage. Un assistant conversationnel affiché en direct pendant qu’un client attend une réponse rend chaque milliseconde perceptible. Une automatisation qui trie, classe ou route un message en arrière-plan, sans personne devant un écran à cet instant, absorbe le même délai sans que quiconque le remarque.
La distinction utile n’est donc pas « rapide » contre « lent », mais « gênant » contre « bloquant ». Un délai gênant ralentit une interaction en direct sans empêcher le travail. Un délai bloquant empêche une décision d’être prise dans la fenêtre de temps où elle a de la valeur (un système de contrôle en temps réel, par exemple, hors du champ des usages professionnels courants).
| Type d’usage | Effet du délai | Exemple |
|---|---|---|
| Assistant conversationnel en direct | Gênant si mal maîtrisé, rarement bloquant | Chatbot client qui répond en quelques secondes. |
| Automatisation en arrière-plan | Généralement sans effet perceptible | Tri d’un message, extraction d’une donnée, comptes rendus. |
| Contrôle en temps réel | Potentiellement bloquant | Hors du champ des automatisations métier courantes en PME. |
Faites défiler le tableau pour comparer les colonnes
Ce que montrent déjà les bancs d’essai publics du modèle pris comme exemple
Pour donner un ordre de grandeur concret, prenons Jev, le modèle de décision de l’éditeur TypeSafe AI lancé le 15 septembre 2026 et disponible sur Cloudflare AI Gateway : sa fiche modèle Cloudflare annonce une fenêtre de contexte de 32 000 tokens et un fonctionnement par questions typées, sans génération de texte libre. Ce choix d’exemple n’est pas un jugement sur cet outil précis : c’est le seul modèle de ce type pour lequel plusieurs bancs d’essai indépendants ont déjà été publiés à la date de rédaction.
L’éditeur revendique un temps de réponse de 70 à 500 millisecondes de bout en bout, et une facture de 0,042 dollar par million de tokens en entrée, la sortie étant gratuite (typesafe.ai, annonce du 15 septembre 2026). The Register a relayé une démonstration chiffrée à 0,114 seconde pour Jev contre 8,566 secondes pour un modèle de langage généraliste sur la même tâche (16 septembre 2026). TypeSafe reconnaît elle-même que ces chiffres sont mesurés en interne, sur des tâches choisies par ses équipes, et qu’ils se situent probablement « en haut de la fourchette » des résultats réels.
Deux vérifications indépendantes, publiées la même semaine, nuancent ce chiffre sans le contredire dans sa direction. Le média Every a testé Jev sur une tâche d’extraction concrète et mesuré environ 25 fois plus rapide et environ 580 fois moins cher que Claude Fable 5.1, pour une précision légèrement inférieure (Jev a repéré six défauts sur sept dans le texte testé, contre sept sur sept pour le modèle comparé). Le laboratoire Good Start Labs, cité par Langfuse (18 septembre 2026), a fait passer 6 003 vérifications à Jev : il concorde avec les verdicts de Claude Fable 5.1 dans 91,5 % des cas, pour un coût de 160 dollars le million de réponses évaluées contre 33 000 dollars pour Claude Fable 5.1 sur le même volume. Un modèle concurrent, DeepSeek V4.1 Flash, obtient un taux de concordance légèrement supérieur (93,5 %) pour un coût de 260 dollars.
Ces mêmes sources posent des limites claires à ce type de modèle : il ne peut pas s’abstenir de répondre, sa fiabilité se dégrade quand le texte fourni contient des informations sans rapport avec la question, et il ne traite pas le calcul ni les dates complexes. Ce sont des limites de calibration et de conception, pas des questions de réseau : elles ne changent rien au sujet de cette page, elles montrent seulement que la vitesse d’un modèle et sa fiabilité se mesurent séparément.
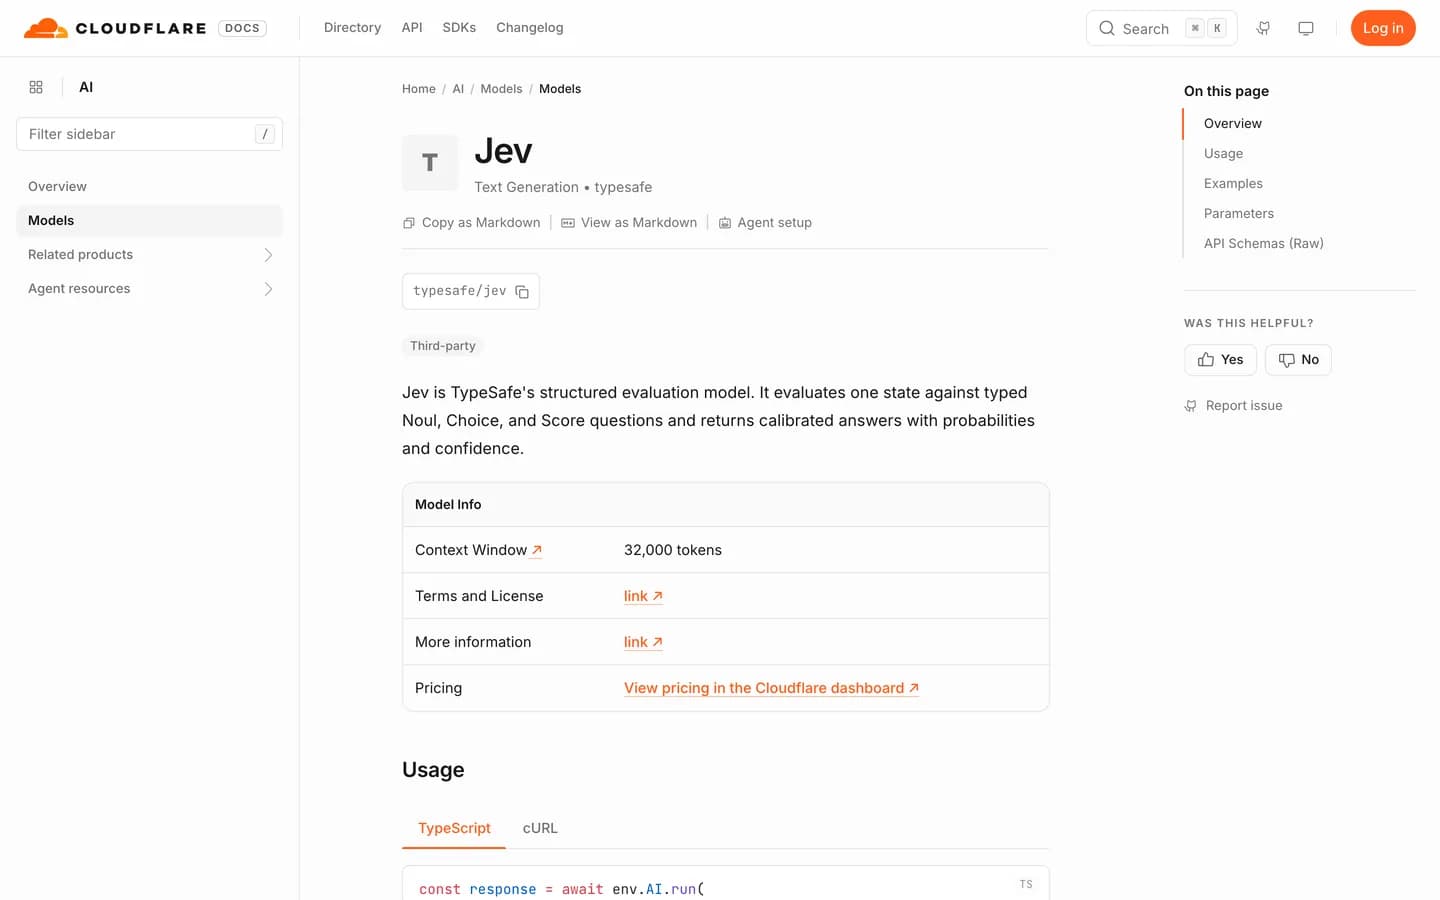
| Source | Nature du test | Résultat rapporté |
|---|---|---|
| TypeSafe AI (éditeur, 15/09/2026) | Mesure interne, tâches choisies par l’équipe | 70 à 500 ms ; 193,6x plus rapide, 444,6x moins cher (haut de fourchette assumé) |
| Every (indépendant, tâche d’extraction) | Un test, comparé à Claude Fable 5.1 | ≈ 25x plus rapide, ≈ 580x moins cher ; six défauts détectés sur sept |
| Good Start Labs / Langfuse (18/09/2026) | 6 003 vérifications, comparées à quatre modèles | 91,5 % de concordance avec Claude Fable 5.1 ; 160 $ le million de réponses |
Faites défiler le tableau pour comparer les colonnes
Ce qui dépend du réseau local et ce qui dépend de l’outil IA choisi
Une partie de ces mesures se joue avant même d’atteindre le modèle. Cloudflare, qui héberge la fiche Jev et sert de porte d’entrée à de nombreux outils IA, liste officiellement « Saint-Denis, RE » parmi les villes de son réseau mondial (cloudflare.com/network/, consulté le 20 septembre 2026). Un point de présence sur l’île réduit la partie du trajet qui s’arrête à la périphérie du réseau (mise en cache, filtrage, première réception de la requête), mais le calcul du modèle lui-même continue de s’exécuter là où tourne le matériel de calcul, pas nécessairement à La Réunion.
Le relevé public de la démo askjev.ai (19 septembre 2026, 172 appels observés) illustre cette distinction : les temps qu’il rapporte (117 ms au minimum, 188 ms de médiane, 622 ms au maximum) sont mesurés côté serveur de la démonstration, entre la requête et la réponse de Jev. Ils n’incluent pas le trajet depuis un poste réunionnais jusqu’à ce serveur : c’est exactement la part que le réseau local ajoute par-dessus, et qui varie selon la connexion.
| Ce qui dépend du réseau local | Ce qui dépend de l’outil IA choisi |
|---|---|
| Le trajet jusqu’au premier point de présence (câble sous-marin, box, Wi-Fi). | Le temps de calcul du modèle une fois la requête reçue. |
| La qualité et la stabilité de la connexion (filaire, Wi-Fi, congestion). | La taille du modèle, son architecture, et sa charge au moment de l’appel. |
| Le nombre de sauts réseau avant d’atteindre un point de présence. | Le lieu où tourne réellement le calcul (pas toujours celui du point de présence). |
Faites défiler le tableau pour comparer les colonnes
Les leviers réellement disponibles pour une entreprise réunionnaise
Aucun de ces leviers ne supprime la distance physique. Chacun agit sur une part différente du délai perçu, et se combine avec les autres plutôt que de s’y substituer.
- Privilégier une connexion filaire à un poste de travail sensible à la latence : le Wi-Fi ajoute une variabilité que le câble n’a pas, avant même de sortir de l’île.
- Vérifier si l’outil IA passe par un point de présence ou une tarification qui inclut déjà un relais proche (Cloudflare AI Gateway, par exemple, ne facture aucun surcoût de passerelle au-delà du tarif du fournisseur du modèle).
- Choisir une architecture d’automatisation tolérante à l’attente pour les tâches qui n’ont pas besoin d’un résultat instantané : un traitement en arrière-plan absorbe un délai de quelques centaines de millisecondes sans qu’aucun client ne le perçoive.
- Réserver l’exigence de vitesse maximale aux usages réellement en direct devant un client, et accepter un délai plus large pour tout le reste.
Ce qui se règle côté hébergement et côté architecture
Les leviers précédents sont à la portée de l’utilisateur. Ceux-ci relèvent de la personne qui construit l’outil : prestataire, développeur ou équipe technique. Ils ne suppriment pas non plus la distance, mais ils réduisent le nombre de fois où la requête la parcourt et le temps pendant lequel l’utilisateur attend sans rien voir.
Chaque levier se vérifie avec la méthode de mesure de la section suivante, avant et après le changement : un réglage qui ne se voit pas dans les mesures n’a pas besoin d’être conservé.
| Réglage | Ce qu’il change | À vérifier |
|---|---|---|
| Choisir la région d’hébergement la plus proche proposée | Raccourcit le trajet jusqu’au calcul du modèle. | Les régions réellement offertes par le fournisseur, et où vont les données. |
| Regrouper les questions en un seul appel | Un aller-retour au lieu de plusieurs ; la démo askjev.ai pose six questions par appel. | Que l’outil accepte plusieurs questions dans la même requête. |
| Afficher la réponse au fil de l’eau | L’utilisateur voit les premiers mots sans attendre la réponse complète. | Utile pour un assistant qui rédige ; sans objet pour un modèle qui renvoie une note. |
| Traiter en arrière-plan ce qui peut attendre | Le délai n’est plus vécu par personne. | Que le résultat ne soit pas attendu en direct par un client. |
Faites défiler le tableau pour comparer les colonnes
Vérifier vous-même : la méthode pour mesurer votre latence
Cette méthode ne mesure pas un modèle d’IA en particulier : elle mesure la part réseau, celle qui dépend de votre connexion et de votre position à La Réunion, indépendamment de l’outil choisi ensuite. Elle se rejoue depuis n’importe quel poste, sans installation.
- Répétez la mesure vingt fois, à des heures différentes de la journée : la latence réseau varie avec la charge du réseau, pas seulement avec la distance.
- Notez le temps de connexion (`time_connect`) séparément du temps total : le premier est la part réseau, le second inclut le traitement côté serveur.
- Comparez une cible filaire et une cible en Wi-Fi depuis le même lieu pour isoler la part qui vous appartient de celle qui ne dépend pas de vous.
- Refaites la même série depuis une deuxième connexion, par exemple le partage de connexion mobile d’un téléphone : si l’écart est net, une partie du délai vient de votre accès, pas de l’outil IA.
# Remplacez la cible par le point de présence ou l'API à mesurer
for i in $(seq 1 20); do
  curl -o /dev/null -s -w "essai $i : connect=%{time_connect}s tls=%{time_appconnect}s total=%{time_total}s\n" \
    https://votre-cible.example.com/
  sleep 1
doneUn délai perceptible ne veut pas dire un projet IA irréaliste
Un dirigeant qui perçoit un délai avec un assistant IA a raison de le remarquer : la distance qui sépare La Réunion des principaux points d’hébergement mondiaux est réelle et mesurable. Elle ne rend pas pour autant un projet d’automatisation irréaliste. Les modèles conçus pour des décisions répétitives, comme celui pris en exemple plus haut, répondent déjà en centaines de millisecondes selon leur éditeur et selon deux vérifications indépendantes publiées la même semaine : la plupart des automatisations métier, tri de messages, comptes rendus, chatbots de premier niveau, tolèrent cet ordre de grandeur sans que le client final s’en aperçoive.
La bonne question n’est donc pas « la latence va-t-elle bloquer mon projet ? », mais « quelle part de mon usage se joue vraiment en direct, devant un client, et laquelle peut attendre quelques centaines de millisecondes sans que personne ne le sache ? ». C’est cette question qui oriente le choix d’architecture, pas la distance seule.
Les mesures de DodoIA depuis un réseau réunionnais viendront compléter ce dossier avec des temps de bout en bout mesurés sur ses propres cibles : l’outil de mesure, partagé avec La Refonte, est déjà déployé.
Le guide d’implémentation de référence sur Cloudflare Workers AI
On prend le temps d’expliquer.
Vos questions, des réponses concrètes.
La latence réseau est-elle bloquante pour un projet IA à La Réunion ?
Rarement, pour les usages professionnels courants. Elle ajoute quelques centaines de millisecondes, ce qui gêne un usage entièrement en direct mais ne bloque presque jamais une automatisation qui s’exécute en arrière-plan.
Quelle est la latence réseau typique entre La Réunion et l’Europe ?
Selon le fournisseur d’accès ZEOP (20 septembre 2026), le plancher théorique se situe autour de 180 à 200 ms vers l’Europe continentale, du fait de la distance (plus de 10 000 km) et du trajet par câble sous-marin. La latence réelle observée dépend ensuite de votre propre connexion.
Cloudflare a-t-il un point de présence à La Réunion ?
Oui : Cloudflare liste « Saint-Denis, RE » parmi les villes de son réseau mondial. Cela raccourcit la partie du trajet qui s’arrête à ce point de présence, mais le calcul d’un modèle d’IA continue de s’exécuter là où tourne le matériel, pas nécessairement sur l’île.
Combien de temps répond Jev, le modèle de décision pris en exemple ?
Son éditeur, TypeSafe AI, annonce 70 à 500 millisecondes de bout en bout (15 septembre 2026). Deux vérifications indépendantes publiées la semaine suivante (Every ; Good Start Labs via Langfuse) confirment un ordre de grandeur du même type, sans reproduire exactement les mêmes chiffres.
Le Wi-Fi personnel est-il responsable du délai que je perçois ?
Il peut en faire partie, mais ce n’est qu’une des parts du trajet. La méthode publiée sur cette page permet de mesurer votre propre part réseau, séparément du temps de traitement de l’outil IA utilisé.